# AcademicAI

Usando inteligência artificial para auxiliar na produtividade acadêmica

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FgfG60PLZ5lugMH1OC2VL%2F%3Dcover.png?alt=media&amp;token=a114a1e7-036c-4604-a9f5-40b416edcb86" alt=""><figcaption></figcaption></figure>

[Compre na Amazon](https://www.amazon.com.br/dp/B0BZMYDSMC)!

Compre no [Google Books](https://play.google.com/store/books/details?id=dCP6EAAAQBAJ). (também em formato audiolivro)

## Começando.....

Cada página dessa documentação fala de uma ferramenta do AcademicAI. Explore as páginas e aprenda sobre o AcademicAI.


# Bot para revisão da literatura

Esse bot foi criado para te ajudar a juntar pedaços de documentação em um texto coerente.

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FHFj3a1E8ub4kbDuE67fM%2Fimage.png?alt=media&amp;token=c6fdb32d-c49e-44c8-91d5-4345f5cead87" alt=""><figcaption></figcaption></figure>

{% hint style="info" %}
Você pode encontrar o bot [aqui](https://www.jovempesquisador.com/literaturereviewbot).
{% endhint %}

{% hint style="info" %}
Você pode encontrar todas as ferramentas [aqui](https://www.jovempesquisador.com/academicsaitools), inclusive, novas ferramentas e melhores.
{% endhint %}

O ChatGPT é uma inteligência artificial focada em textos. Com essa IA, você consegue fazer basicamente qualquer tarefa que possui textos como base. Essa inteligência artificial foi desenhada de forma genérica, sem ser amarrada a uma atividade específica. Apesar de não ser uma inteligência artificial genérica, seria o mais o próximo que temos nos tempos atuais.  A openAI, empresa por trás do chatGPT, está constantemente lançando novas versões.&#x20;

{% hint style="success" %}
Essas ferramentas do AcademicAI procura explorar esse mundo dos modelos de linguagens aplicados ao mundo da pesquisa, da escrita e análise de dados.
{% endhint %}

Um exemplo seria *revisão da literatura*. Essa ferramenta ajuda a juntar as anotações que você fez de artigos, e colocar em um formato coerente. Basicamente, quando vai lendo artigo, simplesmente salve anotações, e coloque na caixa de texto para obter um texto coerente, partindo das anotações sua.

{% hint style="danger" %}
**Citação direta** deve ser colocada entre aspas, e citação indireta, como comentários seus, sem aspas. Você consegue trabalhar com citações na segunda versão da ferramenta. [Saiba mais](https://academicai.jovempesquisador.com/bot-para-revisao-da-literatura-1).&#x20;
{% endhint %}

Todo trabalho científico precisa fazer revisão da literatura. Nesse processo, o(a) pesquisador(a) procura evidências para sua pesquisa, quando não acha, seu trabalho ganha importância por ser inovador. Quando acha, é trabalho de cada pesquisador referenciar os trabalhos já publicados. Ninguém deve reinventar a roda. Outra função da revisão da literatura é comparar abordagens e comparar os resultados com o objetivo de mostrar a importância da nova abordagem mostrada no artigo científico.

{% hint style="danger" %}
**Limitações**. Esse bot não faz busca na internet, é trabalho do pesquisador fazer a busca e anotar para então usar o bot, que vai costurar tudo. Contudo, o *RefWiz* faz busca na internet, em um banco de dados científico. [Saiba mais](https://www.jovempesquisador.com/post/refwizscholars-buscando-o-semantic-scholars).
{% endhint %}

## Motivação

Ainda no início da graduação, eu fiz uma disciplina muito importante: metodologia científica. Colocado de forma resumida: essa metodologia foca em como fazer pesquisa, desde tópicos básicos a tópicos avançados. Isso inclui o uso de fontes, de referências, o processo de escrita.

Além de ensinamentos em como fazer pesquisa, embasar trabalhos e mais, também fiz uma parte onde se ensinava a anotar.

É simples: sempre que for ler algo, separe partes dos textos.

Fiz isso desde a graduação, como sempre gostei de dizer, quando ia escrever, o trabalho se escrevia por si próprio: o processo flui que uma beleza. Isso ocorre porque a parte de achar conexões é feito em momento diverso do momento de colocar o trabalho nos finais. Por mais que as pessoas parecem em insistir em fazer tudo no final: procrastinação e pressão não funcionam para a maioria. Seja realista, e faça tudo dentro dos limites de tempo dado, começando hoje.

{% hint style="info" %}
Estou trabalhando em uma versão onde vai poder salvar sua anotações no site, e depois quando terminar, resumir tudo. O que acha? 🤔🤔🤔
{% endhint %}

Notei que muitas pessoas com dificuldades de escrever quando chegava a hora de escrever: as pessoas deixavam para escrever tudo, inclusive a revisão da literatura, no final. Isso geralmente gerava paralisia, “brancos”. Não há vídeos do YouTube que resolva, até santo tem seus limites.

{% hint style="danger" %}
**Importante**: não deixe a revisão da literatura para última hora.&#x20;
{% endhint %}

Nosso cérebro não consegue manter tantas informações armazenadas, e lidar com o estresse de finalizar o trabalho ao mesmo tempo. Nosso cérebro trabalha melhor quando damos tempo a ele para trabalhar em *background*. &#x20;

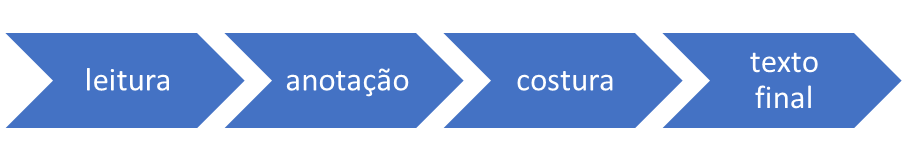
Sempre segui os seguintes passos, bem simples:

·        **Separe um arquivo Word** - use para ir separando as anotações. Não se esqueça de colocar os referências perto, para depois não esquecer de onde tirou. [Saiba mais](https://academicai.jovempesquisador.com/bot-para-revisao-da-literatura-1) como usar a segunda versão dessa ferramenta que aceita as fontes, e gera o resumo com as fontes e uma lista de citações.;

·       **Leia tudo que achar importante para sua pesquisa**;

·        **Marque partes dos textos e artigos**;

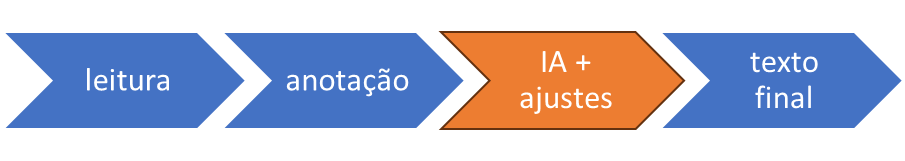
·        **Quando for escrever a revisão da literatura, somente junte tudo em um texto coeso**. Chamo esse processo de costurar, e será onde a IA vai entrar;

Alguns detalhes importantes:

·        **Coloque entre aspas cortes fieis, são citações diretas**;

·        Coloque fora das aspas comentários e quando você mesmo reescrever ou mesmo resumir um texto ou pedaço;

·        Coloque sempre perto dos cortes a citação do texto original.

Dicas:

·        Para PDF, simplesmente marque. Quando for fazer a revisão da literatura, simples busque as marcas;

·        O PDF permite colocar comentários nas marcas, use isso para não esquecer do que estava pensando no momento;

·        Nos comentários, tente fazer conexões com outras leituras;

·        Não se preocupe com ordem, isso é fácil de arrumar depois;

·        Quando for palestras, vídeos e mais, anote assim mesmo. Coloque links quando tiver;

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FYXdXFZ78AFL1TLzsoQOH%2Fimage.png?alt=media&amp;token=3a03f52f-e9de-4b2a-b0db-6b74819bb5bf" alt=""><figcaption><p>Processo sem IA</p></figcaption></figure>

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FJQlRaBnKE1eromflqxQ5%2Fimage.png?alt=media&amp;token=9b719d91-f3fb-48a4-a4a0-00b403ecf953" alt=""><figcaption><p>Processo com IA</p></figcaption></figure>

## Usando nosso bot

Agora vem a parte mais divertida: ***usar a inteligência artificial***.

Abaixo três anotações como geralmente faço. Isso geralmente é um arquivo de Word, cheio de anotações.

“O método científico deve ser usado sempre em casos complicados (Pedro, 2022)”

“O uso da ciência, quando bem feito, beneficia a sociedade. Isso precisa ser feito usando o método científico (Pires, 2000)”

“O método científico não pode ser aplicado em todos os casos, em alguns casos, a experiência do pesquisador vale mais (Guerra, 2033)”

Resultado:

O método científico é amplamente utilizado para investigar fenômenos complexos e obter resultados confiáveis. Segundo Pedro (2022), é essencial aplicar o método científico em situações complicadas, a fim de alcançar uma compreensão sólida e precisa dos fenômenos estudados.

&#x20;

&#x20;

A ciência, quando utilizada de maneira adequada, traz benefícios significativos para a sociedade. Conforme destacado por Pires (2000), é fundamental empregar o método científico para validar as informações obtidas e fornecer bases sólidas para o avanço do conhecimento.

Por outro lado, Guerra (2033) argumenta que o método científico não é aplicável em todas as situações. Em algumas circunstâncias, a experiência do pesquisador pode ter mais peso do que seguir estritamente os passos do método científico. No entanto, é importante ressaltar que essa perspectiva necessita de maiores aprofundamentos para propor métodos alternativos ou complementares ao método científico tradicional.

Em síntese, o método científico é uma abordagem essencial para a investigação científica, especialmente em casos complexos. Seu uso adequado proporciona benefícios significativos à sociedade, garantindo a obtenção de resultados confiáveis e reproduzíveis. No entanto, é pertinente considerar a perspectiva de que em alguns casos a experiência do pesquisador pode ter um papel importante. Futuros estudos devem examinar essa perspectiva e propor abordagens alternativas ou complementares ao método científico tradicional, a fim de proporcionar uma visão mais ampla e abrangente do avanço científico.

## Como fazer?

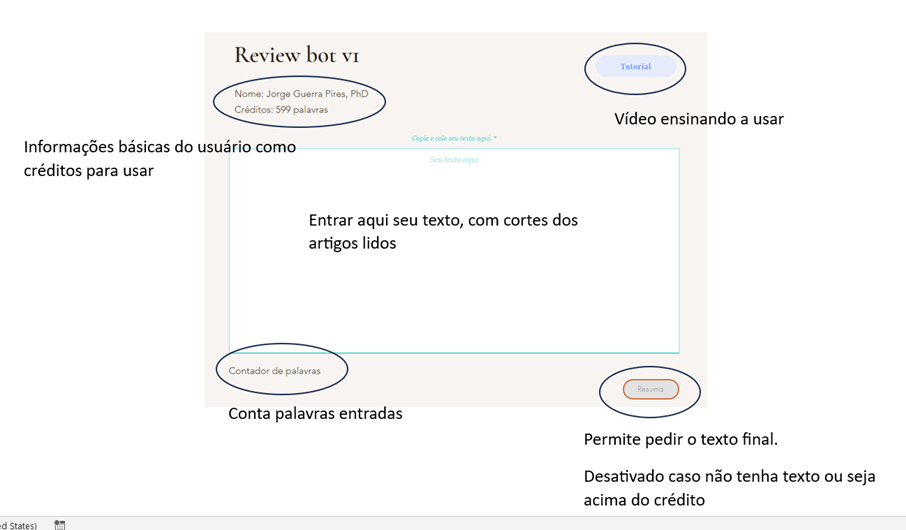
<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FhObdBcl81fwsusEy1C5p%2Fimage.png?alt=media&amp;token=10afc096-31f2-46b0-8193-3a7bcb41b7fb" alt=""><figcaption></figcaption></figure>

Alguns detalhes:

·        Você precisa de créditos para usar;

·        O tamanho do texto é contato em palavras;

O valor final é uma soma entre a resposta e a entrada, contando palavras;


# Bot para revisão da literatura

Essa versão permite que coloque as referências, e o bot organiza tudo! 😍😍

Essa ferramenta é interessante por permitir a inclusão de referências, que já automaticamente organizadas juntas com o texto. Você pode fazer uma lambança, e a IA faz o resto.

{% hint style="info" %}
Você pode acessar a ferramenta [aqui](https://www.jovempesquisador.com/literaturereviewbotv2).
{% endhint %}

O processo é o mesmo do anterior, mas nesta opção você consegue formar o padrão:

Anotações

Referência

Esse padrão é mais realista da forma como eu faço.

Abaixo um exemplo típico.

“Startups na área de saúde é crucial para reduzir custos”

Achei interessante essa passagem por destacar a importância da inovação na área de saúde.

Pires JG. Alguns insights em Startups um novo paradigma para a tríplice aliança ciência, tecnologia e inovação: a novel paradigm for understanding the triple alliance of Science, Technology and Innovation. Rev. G\&amp;S \[Internet]. 1º de fevereiro de 2020 \[citado 20º de abril de 2023];11(1):38-54. Disponível em: <https://periodicos.unb.br/index.php/rgs/article/view/28626>

&#x20;

Achei importante esse livro porque destaca que genialidade nem sempre defini um pesquisador, juntando com a anterior, nos leva a crer que startups podem ser uma fonte para a inclusão de pessoas dentro do mundo da pesquisa, sem ter uma carreira acadêmica tradicional.

Jorge Guerra Pires. Qual é o traço mais importante de um pesquisador? : cai por terra a ideia de QI alto.  Edição do autor (9 abril 2022). eBook Kindle.

“Algoritmos pode a vir a substituir humanos” grande parte do processo decisório na medicina pode ser automatizado.

Jorge Guerra Pires. O caso do algoritmo malvado que seleciona bolsistas CNPq: não joguemos a criança fora. Blog Jovem Pesquisador. <https://www.jovempesquisador.com/post/o-caso-do-algoritmo-malvado-que-seleciona-bolsistas-cnpq>. Acessado em 20/04/23.

&#x20;

Resposta

A introdução de tecnologias inovadoras tem sido fundamental para aprimorar a qualidade, eficiência e acessibilidade dos serviços de saúde. Nesse contexto, as startups na área da saúde desempenham um papel crucial na redução dos custos e no desenvolvimento de soluções inovadoras (Pires, 2020).

&#x20;

Ao contrário do que se pode pensar, a genialidade não é o único traço importante para um pesquisador de sucesso. De acordo com Pires (2022), a inclusão de pessoas no mundo da pesquisa, mesmo sem uma carreira acadêmica tradicional, pode ser feita por meio de startups, promovendo a diversidade de origens e perspectivas nesse campo.

&#x20;

Uma das áreas em que a tecnologia tem tido um impacto significativo é a medicina. Os avanços na área de algoritmos têm permitido a automatização de parte do processo decisório médico, substituindo a necessidade de intervenção humana em certas tarefas (Pires, 2023).

&#x20;

A incorporação de startups na área de saúde é vista como uma maneira eficaz de introduzir inovação e reduzir os custos dos serviços. Além disso, a diversidade de perspectivas trazida por essas empresas pode fomentar a inclusão de pessoas com experiências e formações diversas na pesquisa científica. Por fim, a automação de tarefas por meio de algoritmos mostra-se promissora para agilizar e aprimorar o processo decisório médico.

&#x20;

REFERÊNCIAS

&#x20;

PIRES, J. G. Alguns insights em Startups um novo paradigma para a tríplice aliança ciência, tecnologia e inovação: a novel paradigm for understanding the triple alliance of Science, Technology and Innovation. Rev. G\&amp;S, v. 11, n. 1, p. 38-54, 2020. Disponível em: <[https://periodicos.unb.br/index.php/rgs/article/view/28626>](https://periodicos.unb.br/index.php/rgs/article/view/28626>). Acesso em: 20 abr. 2023.

&#x20;

PIRES, J. G. Qual é o traço mais importante de um pesquisador? : cai por terra a ideia de QI alto. Edição do autor, 2022. eBook Kindle.

&#x20;

PIRES, J.G. O caso do algoritmo malvado que seleciona bolsistas CNPq: não joguemos a criança fora. Blog Jovem Pesquisador. Disponível em: <[https://www.jovempesquisador.com/post/o-caso-do-algoritmo-malvado-que-seleciona-bolsistas-cnpq>](https://www.jovempesquisador.com/post/o-caso-do-algoritmo-malvado-que-seleciona-bolsistas-cnpq>). Acesso em: 20 abr. 2023.

&#x20;

Note que o formato é organizado pela inteligência artificial: você faz a bagunça, ela organiza!

Eu acho isso fenomenal!

{% embed url="<https://www.youtube.com/watch?t=155s&v=WqigWuG5FSE>" %}


# RefWiz

Encontre artigos reais, usando bancos de dados de artigos científicos que reconhecem preprints e artigos publicados em revistas. Embase suas ideias com artigos científicos.

Nesta versão da nossa ferramenta, vamos usar o *Semantic Scholars*: uma ferramenta que busca nas principais bases de dados!&#x20;

{% hint style="info" %}
Para alguns isso pode ser negativo, mas essa plataforma trata *preprints* como artigos. Eu tenho achado isso valioso uma vez que *preprints* mostram o estado da arte. Para saber se é um preprint, click no link do artigo, o artigo estará marcado como preprint. Artigos podem levar meses para serem publicados, se forem, ao passo que preprint seria pessoas experimentando. [Saiba mais sobre preprints](https://www.jovempesquisador.com/post/o-que-s%C3%A3o-os-preprints-e-como-usar).
{% endhint %}

Como é uma ferramenta em desenvolvimento, vem mais truques no futuro. Como exemplo, seria legal poder fazer perguntas aos resultados!

No momento, estamos limitados aos 10 resultados principais.

## Como usar?

{% hint style="info" %}
Postagem de blog: [*RefWizScholars: buscando o Semantic Scholars*](https://www.jovempesquisador.com/post/refwizscholars-buscando-o-semantic-scholars)
{% endhint %}

{% embed url="<https://www.youtube.com/watch?t=68s&v=y8KU8eHyeUA>" %}

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FeAHyhgtbletIWOZRBXsI%2Fimage.png?alt=media&amp;token=085e1434-3937-4cee-989b-19e31e2f3576" alt=""><figcaption><p>Sua informações, como falor em créditos. Lembrete: você recebe uma cortesia em começar a usar a ferramenta, mas precisa recarregar para continuar usando!</p></figcaption></figure>

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2F8X6VztFG14zTvoPcAJhT%2Fimage.png?alt=media&amp;token=8ec891a6-4c59-4e4c-8747-e98baf7f9d32" alt=""><figcaption></figcaption></figure>

### Examplo #1: classificação de serpentes usando transferência de conhecimento&#x20;

> I believe it is possible to make snake classification using transfer learning

{% hint style="info" %}
Buscas em inglês dão resultados melhores, mas pode tentar em português. Vão aparecer artigos em português
{% endhint %}

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2F7hUroMfWJP8L60Ec3Dam%2Fimage.png?alt=media&amp;token=9337e0c5-d89b-4da8-a05e-315723381a69" alt=""><figcaption><p>Resutado da busca, sõa escolhido os 10 primeiros artigos que aparecem na lista. O Resumo que consegue gerar usa somente esses artigo, os resumos. Precisa ler os artigos para confirmar, ou mesmo, considera outros artigos. Isso seria ideia para te ajudar, não como revisão final. Um cenário interessante é quando começa a pesquisar em uma área, pela primeira vez, ou gostaria de saber mais sobre uma área em específico.</p></figcaption></figure>

Ao apertar o botão para resumir.

> The application of transfer learning in snake classification is gaining traction due to its efficiency and adaptability. Various studies demonstrate its potential; for instance, Pires (2021) showcased a user-friendly app that facilitates species identification using deep learning models, emphasizing the ease of constructing these without extensive coding knowledge. Meanwhile, Desingu and Kumar (2021) developed a classifier combining image and geographic data, achieving notable results with the Inception ResNet V2 architecture. Additionally, Yang and Sinnott (2021) explored deployment in mobile environments, further indicating the technology's versatility and effectiveness in snake species classification.&#x20;
>
> **References**:&#x20;
>
> PIRES, Jorge Guerra. SnakeFace: a transfer learning based app for snake classification. 2021.&#x20;
>
> DESINGU, Karthik; KUMAR, Mirunalini J. Snake Species Classification using Transfer Learning Technique. 2021.&#x20;
>
> YANG, Z.; SINNOTT, R. Snake Detection and Classification using Deep Learning. 2021.


# SheetChat

Converse com seus dados! Faça perguntas à sua planilha de Excel, e obtenha respostas baseadas em evidências.

Desde que o chatGPT foi lançado, tivemos uma continuação com novos modelos da openAI. Em questão de meses, o chatGPT ficou obsoleto. Apesar de que eu uso muito o termo chatGPT, ele já está obesoleto, uso de forma genérica.&#x20;

Existem inúmeras aplicação legais dos modelos de linguagens, inteligência artificial aplicada à linguagem humana.&#x20;

Esta aplicação junta ciência de dados com inteligência artificial.&#x20;

Imagine o seguinte cenário. Você fez vários experimentos, e precisa analisar os dados. Como exemplo, você tem um grupo controle e experimental, e gostaria de provar algo entre eles. Isso geralmente é feito com softwares como R. O problema é que nem mesmo pessoas treinadas, como eu, conseguem lembrar tudo, as nuanças da estatística. Eu nunca lembro onde usar um teste t, apesar de ter aprendido isso trossentas vezes. Óbvio, pode usar o Google, e isso já foi outra evolução. os modelos de linguagens nos levam um passo a mais. O chatGPT colocou o Google no bolso, isso ficou evidente, em vez de vasculhar páginas, eles mesmo vasculham para você!

{% hint style="info" %}
Artigo científico, para quem gosta de revisão por pares: [Data Science Using OpenAI: Testing Their New Capabilities Focused on Data Science](https://www.qeios.com/read/76QMHB.2)
{% endhint %}

## Como usar?

{% embed url="<https://www.youtube.com/watch?v=k5T9RT0No4I>" %}

{% hint style="info" %}
Postagens de blog: [AcademicAI: Podemos dizer que evangélicos diferem dos católicos na questão do aborto?](https://www.jovempesquisador.com/post/academicai-podemos-dizer-que-evang%C3%A9licos-diferem-dos-cat%C3%B3licos-na-quest%C3%A3o-do-aborto?fbclid=IwZXh0bgNhZW0CMTEAAR1Q6D9phODpc4mkJBRHIdt7RjrmiRmYio1ZxVIajY4ZwWpBXLkFAjDsz2c_aem_nlvfTmE1FsIolkwLyrkAbw)

[O que os dados nos dizem sobre religião e política em Antônio Pereira](https://jorgeguerrapiresphd.wixstudio.io/eleicoesap/post/o-que-os-dados-nos-dizem-sobre-religi%C3%A3o-e-pol%C3%ADtica-em-ant%C3%B4nio-pereira)
{% endhint %}

## Exemplo: estudo da diabetes usando +10.000 amostras!&#x20;

Vamos usar esse exemplo da diabetes, mas o artigo citado tem muitos outros exemplos. Ver também o tutorial em vídeo sugerido.

{% hint style="info" %}
[Vamos usar esse banco de dados do Kaggle](https://www.kaggle.com/datasets/iammustafatz/diabetes-prediction-dataset). São mais de 10.000 amostras de pacientes com diabetes. Isso inclui 8 informações do paciente, como se é fumante, e se o paciente é diabético. &#x20;
{% endhint %}

{% hint style="success" %}
O conjunto de dados de previsão de diabetes é uma coleção de dados médicos e demográficos de pacientes, juntamente com seu status de diabetes (positivo ou negativo). Os dados incluem características como idade, gênero, índice de massa corporal (IMC), hipertensão, doenças cardíacas, histórico de tabagismo, nível de HbA1c e nível de glicose no sangue. Este conjunto de dados pode ser usado para construir modelos de aprendizado de máquina para prever diabetes em pacientes com base em seu histórico médico e informações demográficas. Isso pode ser útil para profissionais de saúde na identificação de pacientes que podem estar em risco de desenvolver diabetes e no desenvolvimento de planos de tratamento personalizados. Além disso, o conjunto de dados pode ser usado por pesquisadores para explorar as relações entre vários fatores médicos e demográficos e a probabilidade de desenvolver diabetes.
{% endhint %}

### Acesse o AcademicAI: vai precisar logar, suas informações básicas são coletadas

Acessar: <https://www.jovempesquisador.com/academicsaitools>

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2Ft7ATATI4WpUVR2vr8SAu%2Fimage.png?alt=media&amp;token=2dcc7d82-bee0-44dc-a625-ab567170e5d0" alt=""><figcaption><p>Você vai precisar descer até a ferramenta para ciência de dados, são várias e vem mais aí! ❤️❤️ Aperte em <em>Get Started.</em> Isso vai te encaminhar para o app, e vai coletar suas informações com créditos, que ganha de graça quando inicia, e seu nome. </p></figcaption></figure>

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FFnlhDu6IJYdIVJc5ZlDs%2Fimage.png?alt=media&amp;token=c004173b-a6d9-4389-978b-db390527a5d4" alt=""><figcaption><p>Escolha o arquivo, e upload CSV. Isso vai fazer o upload para você. </p></figcaption></figure>

{% hint style="info" %}
Vai precisa baixar o arquivo no seu computador, fazer o unzip. Pode usar outro banco de dados se quiser, não faz a diferença. A ferramenta até corrigi para você se tiver problemas na formação dos dados, como em PT usamos vírgulas para decimais, em inglês eles usam ponto. A ferramenta corrige isso.&#x20;
{% endhint %}

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FPMXNPcBYzGPv3RbNGGZu%2Fimage.png?alt=media&amp;token=3a5e8b6f-7a23-4f1e-b082-e1e87432d8fd" alt=""><figcaption><p>Pode começar com um olá, ou ir direto ao ponto. IA não se ofende. 🤣👌👌</p></figcaption></figure>

> Poderia descrever para mim o bando de dados anexado?

> O conjunto de dados contém as seguintes colunas:&#x20;
>
> 1\. gender: o gênero do paciente (por exemplo, masculino, feminino)&#x20;
>
> 2\. age: a idade do paciente&#x20;
>
> 3\. hypertension: se o paciente tem hipertensão (0 para não, 1 para sim)&#x20;
>
> 4\. heart\_disease: se o paciente tem doença cardíaca (0 para não, 1 para sim)&#x20;
>
> 5\. smoking\_history: histórico de tabagismo do paciente 6. bmi: índice de massa corporal do paciente&#x20;
>
> 7\. HbA1c\_level: nível de hemoglobina A1c do paciente&#x20;
>
> 8\. blood\_glucose\_level: nível de glicose no sangue do paciente&#x20;
>
> 9\. diabetes: se o paciente tem diabetes (0 para não, 1 para sim) O conjunto de dados contém 100.000 entradas e não possui valores nulos em nenhuma das colunas.&#x20;
>
> Essas informações iniciais nos ajudarão a explorar e analisar o conjunto de dados com mais detalhes. Se você tiver alguma outra pergunta ou análise específica em mente, fique à vontade para perguntar!

> Seria correto afirmar que cigarro tem qualquer relação com diabetes?

> Para determinar se o histórico de tabagismo tem alguma relação com a diabetes, podemos realizar uma análise estatística comparando a incidência de diabetes entre fumantes e não fumantes. Vamos explorar os dados para ver se podemos identificar alguma relação entre o histórico de tabagismo e a diabetes.
>
> Aqui estão as proporções de casos de diabetes para diferentes históricos de tabagismo: - Sem informação: 4.06%
>
> &#x20;\- Atualmente fumante: 10.21%&#x20;
>
> \- Ex-fumante: 11.79%&#x20;
>
> \- Nunca fumou: 9.53%&#x20;
>
> Ao analisar essas proporções, ***há uma diferença nas taxas de diabetes entre os diferentes grupos***. Isso sugere que **há uma relação entre o histórico de tabagismo e a incidência de diabetes**. Por exemplo, ***ex-fumantes parecem ter uma proporção mais alta de casos de diabetes em comparação com os outros grupos***. No entanto, para afirmar conclusivamente uma relação causal entre o histórico de tabagismo e a diabetes, seria necessário realizar testes estatísticos mais avançados, como testes de hipóteses e análises de regressão para controlar outros fatores potenciais que possam influenciar a presença de diabetes.&#x20;

{% hint style="info" %}
Okay, poderia fazer esses testes que menciona, que seriam avançados?
{% endhint %}

> Claro, podemos realizar testes estatísticos mais avançados para avaliar se a diferença observada na taxa de diabetes entre os grupos de fumantes e não fumantes é estatisticamente significativa. Um teste estatístico comum para comparar as médias entre grupos é o teste t-student ou a análise de variância (ANOVA) para múltiplos grupos. Para avançar com a análise, vou realizar um teste de ANOVA para avaliar se há diferenças estatisticamente significativas na taxa de diabetes entre os diferentes grupos de histórico de tabagismo. Vamos prosseguir com essa análise estatística para confirmar se a diferença observada não é devida ao acaso.
>
> O teste de análise de variância (ANOVA) indicou um ***valor p extremamente baixo*** (p-valor ≈ 2.86e-92), o que sugere fortemente que **há diferenças estatisticamente significativas nas taxas de diabetes entre os diferentes grupos de histórico de tabagismo**. Esses resultados fornecem evidências estatísticas de que o histórico de tabagismo está associado à incidência de diabetes. No entanto, é importante notar que correlação não implica causalidade, e outros fatores não considerados podem influenciar essa relação. Se houver mais alguma análise estatística que você gostaria de explorar ou outras perguntas relacionadas aos dados, fique à vontade para perguntar!

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FnkbtPWh4iR1ngBN0Usr6%2Fimage.png?alt=media&amp;token=4b7b2e79-1b6d-4c61-96af-f5c44fa6f99e" alt=""><figcaption></figcaption></figure>

> Como você fez o teste? você separou em dois grupos? fumantes  e não fumantes?

{% hint style="danger" %}
Uma forma de assegurar que a ferramenta não fez a análise errada é questionar. Óbvio, você precisa ter pelo menos aprendido o básico de análise de dados, e saber certo problemas que podem surgir nessas análises.&#x20;
{% endhint %}

> Na verdade, utilizei um teste de ANOVA (Análise de Variância) para comparar as médias de diabetes entre mais de dois grupos. O teste de ANOVA é uma ferramenta estatística adequada quando estamos lidando com três ou mais **grupos independentes**, como é o caso aqui, onde temos diferentes históricos de tabagismo. O teste ANOVA permite verificar se há diferenças significativas entre as médias de mais de dois grupos independentes. Neste caso, utilizamos as diferentes categorias de histórico de tabagismo (nunca fumou, fumante atual, ex-fumante, etc.) como nossos grupos independentes para comparar a taxa de diabetes. Se houver mais alguma abordagem específica que você gostaria de explorar ou se quiser discutir mais detalhes sobre os testes estatísticos realizados, estou à disposição para ajudar! user: Como você fez o teste? você separou em dois grupos? fumantes e não fumantes?

> Quando você diz "grupos independentes", tem como provar isso? quero dizer: como verificar de que esses grupos são realmente independentes?

> Verificar a independência dos grupos é um passo importante ao realizar testes estatísticos. A independência dos grupos em um teste de ANOVA refere-se ao fato de que as observações em um grupo não devem ser afetadas pelas observações em outro grupo. No contexto do histórico de tabagismo e sua relação com a diabetes, a independência dos grupos pode ser verificada pela aleatorização na seleção dos participantes para cada grupo de tabagismo. Isso significa que a participação de um indivíduo em um grupo de tabagismo não deve influenciar a participação de outro indivíduo em qualquer grupo. Além disso, ao analisar os dados, não devemos encontrar evidências de que a participação em um grupo influencia diretamente a presença de diabetes em outro grupo. Para verificar a independência dos grupos, também podemos examinar a distribuição das características dos participantes em cada grupo e se há alguma interdependência entre eles. Se houver necessidade de uma análise mais aprofundada da independência dos grupos ou se você tiver outras perguntas relacionadas à análise estatística, por favor, sinta-se à vontade para compartilhar!

> O banco de dados tem +10.000 amostras de pacientes. Isso significa que a probabilidade de que esses pacientes se conheçam seja zero. Isso seria uma forma de assumir independência. Concorda?

> Sim, você está corretíssimo. Em um conjunto de dados com mais de 10.000 amostras de pacientes, é razoável assumir que a probabilidade de que esses pacientes se conheçam ou influenciem uns aos outros de forma significativa é extremamente baixa, podendo ser considerada essencialmente zero para fins práticos. Sob essa suposição, podemos considerar que as amostras de pacientes são independentes entre si para efeitos de análise estatística, o que justifica a aplicação de testes estatísticos que pressupõem a independência das observações. Agradeço por trazer esse ponto relevante à nossa discussão. Se houver mais alguma questão sobre a análise estatística dos dados ou outros tópicos que você gostaria de explorar, não hesite em compartilhar. Estou aqui para ajudar!

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2Fz8W8XdLkCh0woFJfstlZ%2Fimage.png?alt=media&amp;token=823a3a87-b6eb-4798-be56-4682db7ef0a4" alt=""><figcaption><p>Toda essa análise, e avançada, não custou nem 10 centavos. 😁👌💕💕</p></figcaption></figure>

{% hint style="info" %}
Caso tenha usado as outras ferramentas, deve ter notado que essa custa mais. Isso porque para que ela funciona, isso envolve muitas outras ferramentas. Como exemplo, ao gerar gráficos, isso é GPT -4 fazendo, a mais cara da openAI. Ou seja, o custo é maior devido a quantidade de detalhes e modelos da openAI usando sem você nem ver.
{% endhint %}

{% hint style="danger" %}
Essa ferramenta custa mais do que as outras por ser várias ferramentas em uma. Ou seja, use com cautela. Cada vez que manda uma mensagem, existe um custo fixo por mensagem mais a quantidade de gasta de tokens.&#x20;

Custo por mensagem = custo fixo (em torno de 70 centavos) + custo por token (em torno de **0,0000084** centavos).

Obs. O preço de **um token** é calculado com base na taxa de **US$ 1,50** por **1 milhão de tokens de saída; preço que pode variar por modelo usado como base**. Isso equivale a aproximadamente **R$ 0,0000084** em Reais brasileiros.&#x20;
{% endhint %}

{% hint style="success" %}
[Esse anexo do artigo tem mais exemplos](https://qeios-uploads.s3.eu-west-1.amazonaws.com/publication-ancillary-files/76QMHB.2/supplementary-material.pdf). Não deixe de ler o artigo para entender o contexto da ferramenta, do SheetChat.&#x20;
{% endhint %}

{% hint style="success" %}
[Nesse anexo](https://qeios-uploads.s3.eu-west-1.amazonaws.com/publication-ancillary-files/76QMHB.2/data-science-with-openai-sm-v2.pdf), eu explico com o SheetChat funciona.
{% endhint %}

{% hint style="success" %}
Se você precisa de alguma forma validar a anállise da IA, uma forma é como ensino [nesse anexo](https://qeios-uploads.s3.eu-west-1.amazonaws.com/publication-ancillary-files/76QMHB.2/data-science-with-openai-sm-v3.pdf).
{% endhint %}

{% hint style="info" %}
[Conjunto de demos](https://sheetchat-4c50d57d9d3e.herokuapp.com/#/demos) usando o SheetChat.
{% endhint %}

{% hint style="info" %}
No passado, eu modelei esse mesmo banco de dados usando Redes Neurais. [Saiba mais](https://seer.ufrgs.br/index.php/rita/article/view/133785).
{% endhint %}


# Cafezinho ☕☕

Tomando um cafezinho com seu artigo científico. Transforme seu artigo em uma conversa e resuma a conversa para anotações.

<figure><img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2F8LmzrLMrBeuZGcgZBO5v%2Fimage.png?alt=media&amp;token=f15889b0-6121-4b2b-b0a8-29473655aac9" alt=""><figcaption></figcaption></figure>

​Fica cada vez mais difícil ficar por dentro da literatura. Na maior parte das vezes, queremos somente saber a essência de um artigo, para citar, não precisamos ficar horas lendo o artigo, ou dias, para pegar a essência. Essa ferramenta vai te ajudar a transformar seu artigo em algo legal, rápido e simples de ler.

## Como usar?

<details>

<summary>Acesse o AcademicAI do nosso site</summary>

[Acesse o link](https://www.jovempesquisador.com/academicsaitools).

Isso vai coletar suas informações: uma conta no site é criada para você, junto com uma conta no AcademicAI.&#x20;

No primeiro acesso, você vai receber créditos para iniciar os testes, e ganhar familiaridade com a ferramenta. Quando acabar seus créditos, precisa recarregar. Isso no momento é feito por pix. Você vai se surpreender o que consegue fazer com 1 real.&#x20;

[Saiba mais](broken://spaces/w0Kdr9JUSlWIVP9qVzGV).

Todas as ferramentas usam os mesmos créditos, ou seja, carrega uma vez, e use todas as ferramentas.

<img src="https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2Fh5CmnCJ8eCOrdtb1qIdk%2Fimage.png?alt=media&amp;token=d7020402-ad35-40f6-a2f0-8820841b4fcc" alt="" data-size="original">

![](https://1660047211-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2F6fFyZ3qCRA7jwJGie8VU%2Fuploads%2FLAEUUhgvLDfgTLELLQ48%2Fimage.png?alt=media\&token=19e37079-b17f-4ed8-8ce4-a0a1290eb355)

<mark style="color:blue;">**Descrição das seções**</mark>

A interface vai muito provavelmente mudar. Mas a essência vai ficar.&#x20;

Na primeira parte, precisa fazer o upload do artigo. Importante, quanto maior o artigo, maior  o custo. Evite enviar artigo quando seu crédito estiver zerando, isso vai travar a resposta. Somente consegue saber quanto gastou quando a resposta volta. Se a soma da resposta ultrapassar seus créditos, isso trava a resposta. Uma vez feito o upload, precisa enviar o arquivo para o modelo.&#x20;

**Fluxo**: Escolher arquivo -> enviar artigo para conversa.&#x20;

Isso vai ativar o chatbot.&#x20;

Note que consegue ver seu nome e quantidade de créditos em reais. Isso vai ser atualizado em tempo real ao usar a ferramenta. Você vai ver quanto gastou por conversa, e o total. Tudo é mostrado em reais, para simplificar tudo. No entanto, no fundo, a cobrança é feita usando tokens, a base dos modelos de linguagem.&#x20;

Assim que enviar, vai aparecer um resumo do texto. No futuro, vai conseguir salvar isso, para gerar textos para seu artigo. A ideia será tudo isso ser salvo na sua conta no AcademicAI. Como todas a ferramentas serão integradas, vai conseguir ir salvando, e gerar um texto para seu artigo quando quiser.

&#x20;

</details>

{% hint style="info" %}
Vamos usar meu artigo para testar. Você consegue baixar. No futuro, talvez, vai conseguir baixar com um link, trabalhando nisso.  [*Data Science Using OpenAI: Testing Their New Capabilities Focused on Data Science*](https://www.qeios.com/read/76QMHB.2)
{% endhint %}

<details>

<summary><mark style="color:purple;">Iniciando a conversa</mark></summary>

</details>

> <pre><code><strong>Structured Description of the Paper
> </strong>
> Title: Data Science Using OpenAI: Testing Their New Capabilities Focused on Data Science
>
> Author: Jorge Guerra Pires, Ph.D.
>
> ---
>
> Introduction:
> The paper addresses the challenges faced by non-statistically trained 
> researchers in applying statistical analyses correctly, 
> often resulting in fundamental errors. 
> It emphasizes the necessity for accessible and effective analytical tools. The study introduces OpenAI's "coder interpreter" API, proposing its potential to aid researchers from diverse backgrounds in conducting sound statistical analysis without requiring deep statistical expertise. This democratization of statistical analysis represents a significant advancement in research methodologies, particularly in fields like evidence-based medicine[0][1].
>
> Methods:
> The methodologies employed involve testing the coder interpreter API, 
> designed to process user commands, analyze CSV data files, 
> and execute statistical analyses by selecting suitable methods and 
> libraries autonomously. The testing focused on real datasets 
> to evaluate the API's user-friendliness for non-experts, 
> assessing its functionalities through practical applications, 
> such as those involving diabetic patients[2][3].
>
> Results:
> The results showed that the coder interpreter successfully utilized 
> open-source Python libraries to conduct accurate statistical analyses. 
> For instance, a case study regarding diabetic patients demonstrated 
> its efficacy in assisting non-expert researchers to interpret and apply 
> their data effectively. 
> The API was able to generate insights and statistical findings 
> without the user needing extensive knowledge of statistical methodologies[4][5].
>
> Discussion:
> The discussion highlights the transformative potential of AI tools 
> like the coder interpreter in scientific research, particularly 
> in easing the process of advanced statistics. 
> This capability enables researchers to concentrate on substantial 
> inquiries rather than the intricacies of statistical methods. 
> The paper advocates for the wider adoption of such technologies 
> to enhance the quality of statistical analyses in scientific research, 
> emphasizing that they could serve both novice and experienced researchers 
> alike[6][7].
>
> ---
>
> This concise description captures the primary sections and 
> contributions of the paper in line with the IMRAD structure. 
> If you need more details or specific aspects of the paper discussed, 
> feel free to ask!
> </code></pre>

Essa primeira interação custou 15 centavos. Basicamente, foi feito um resumo do artigo. O artigo tem 30 páginas.&#x20;

> If I undestand properly, this is a application that can make statistical analysis. Thus, I can start with a dataset, make questions, and get statistical analysis done. WIth no statistical expertise.

{% hint style="info" %}
Você precisa apertar Carregar Mensagens. Espere alguns segundos, e aperte. Se não estiver pronto, espere mais alguns segundos e aperter novamente. Geralmente, em segundos, a resposta fica pronta.
{% endhint %}

> Yes, you understood correctly!&#x20;
>
> The paper presents OpenAI's "coder interpreter" API, which is designed to facilitate statistical analysis for users who may not have a strong background in statistics. Here’s a bit more detail on how it works:&#x20;
>
> \- **User-Friendly Interface**: The API allows users to input commands related to their dataset in natural language or simplified instructions.&#x20;
>
> This means you can start with a dataset and ask questions or request analyses directly. - **Automated Analysis**: The tool automatically selects appropriate statistical methods and libraries to carry out the analysis. It can process data in formats like CSV and perform various statistical operations without requiring the user to know the underlying statistical techniques.&#x20;
>
> \- **Case Studies**: As demonstrated in the paper, the coder interpreter was successfully applied to real datasets (e.g., in studying diabetic patients), producing relevant insights and making statistical findings accessible to non-experts. This application effectively empowers researchers or users with varying levels of statistical expertise to conduct sound analyses, focusing more on the research questions rather than on the complexities of statistical methodologies\[0]\[1].&#x20;
>
> If you have any further questions or need clarification on specific functionalities, just let me know!&#x20;

{% hint style="danger" %}
A ordem da mensagem fica fora de ordens. Estou vendo se melhor isso.&#x20;
{% endhint %}

{% hint style="success" %}
Vai precisar formatar o texto, para seu uso.&#x20;
{% endhint %}

> How can I make sure the analysis is correct? I mean, I want to make sure the statistical analysis was properly done.

> Ensuring the correctness of statistical analyses conducted using tools like the OpenAI coder interpreter involves several steps.&#x20;
>
> Here are some recommendations to help validate the accuracy and reliability of the analyses:&#x20;
>
> 1\. **Understand the Basics of Statistics**: Even though the tool simplifies the process, having a foundational understanding of key statistical concepts (like mean, median, variance, correlation, etc.) will help you critically assess the results.&#x20;
>
> 2\. **Review the Documentation**: Familiarize yourself with the documentation of the API, if available. This will give you insights into the methods and libraries it employs for statistical analysis, including any assumptions made by these methods.&#x20;
>
> 3\. **Cross-Validation**: When possible, conduct the same analysis using different tools or methodologies. For example, if the API processes a dataset, you can validate the results by using traditional statistical software (like R or Python with statistical libraries) or by consulting a statistician. \
> 4\. **Check the Output**: Assess the output closely: - Look for measures of uncertainty (e.g., confidence intervals, p-values). - Understand the context: Are the assumptions for the statistical tests being met? - Evaluate if the findings make sense given the data and the study context.&#x20;
>
> 5\. **Reproducibility**: Ensure the analysis can be reproduced. You can try running the analysis multiple times with different subsets of the data or parameters to see if you get consistent results.&#x20;
>
> 6\. **Seek Expert Consultation**: If you’re unsure about the analysis or the results, consider consulting with a statistician or data scientist who can interpret the findings and validate the methods used.&#x20;
>
> 7\. **Explore Alternative Analyses**: If the analysis seems aligned with the expectations but you're uncertain about its correctness, explore alternative statistical methods that might yield different insights or confirm the findings. By following these steps, you can increase your confidence in the correctness of the statistical analyses performed by the OpenAI coder interpreter or any similar tool\[0]\[1]. If you have further questions or need clarification on specific points, let me know! \[0]76QMHB.2.pdf \[1]76QMHB.2.pdf

Agora aperte em "criar um resumo" -> isso vai resumir a conversa. Ideial para guardar como anotação, para quando for escrever seu trabalho, eu sempre fiz isso manualmente.

Não se esqueça de carregar a mensagem.&#x20;

> The discussion focused on the application of OpenAI's "coder interpreter" API for conducting statistical analyses without requiring extensive statistical expertise. The tool allows users to initiate analyses by inputting questions related to their datasets, while it automates the selection of appropriate statistical methods. To ensure the validity and accuracy of the analyses produced, the conversation emphasized the importance of understanding basic statistical principles, reviewing tool documentation, cross-validation with alternative methods, checking output robustness, ensuring reproducibility, and seeking expert consultation when needed. This approach aims to enhance the reliability of insights derived from automated statistical analysis.

> Poderia responder o resumo em PT/BR?

> A discussão concentrou-se na aplicação da API "coder interpreter" da OpenAI para a realização de análises estatísticas sem a necessidade de um amplo conhecimento em estatística. A ferramenta permite que os usuários iniciem análises ao inserir perguntas relacionadas aos seus conjuntos de dados, enquanto automatiza a seleção de métodos estatísticos apropriados. Para garantir a validade e a precisão das análises produzidas, a conversa enfatizou a importância de compreender princípios estatísticos básicos, revisar a documentação da ferramenta, realizar validação cruzada com métodos alternativos, verificar a robustez dos resultados, assegurar a reprodutibilidade e buscar consulta de especialistas quando necessário. Essa abordagem visa aumentar a confiabilidade das informações derivadas da análise estatística automatizada.

Lembre-se de empresa carregar as mensagens. O resumo aparece como uma mensagem.